主题
知识库 PRD
文档信息
| 项目 | 内容 |
|---|---|
| 产品名称 | PMForge - 知识库 |
| 文档版本 | v2.0 |
| 创建日期 | 2026-09-24 |
| 最后更新 | 2026-09-24 |
| 文档状态 | 评审中 |
| 优先级 | P0 |
一、功能概述
1.1 功能定位
知识库是 PMForge AI 模块的核心子模块之一,为用户提供基于向量数据库的企业知识管理能力。
通俗理解:把知识库模块想象成一位"超级图书管理员"。你把公司所有的文档(产品手册、技术方案、规章制度)都交给他,他会仔细阅读每一页,把内容切成一个个知识片段,并为每个片段建立"语义索引"——不是按关键词,而是按"意思"来理解。当你问他"产品的 API 接口规范是什么?"时,他不是去搜索包含"API"这个词的文档,而是真正理解你的问题,找到语义上最相关的段落,然后结合 AI 大模型给你一个精准的回答,并标注这段话出自哪份文档的第几段。整个过程就像 RAG(检索增强生成)——先找到相关资料,再让 AI 基于资料回答,而不是让 AI 凭记忆瞎编。
模块支持将 PDF、Word、TXT、Markdown、HTML 等多种格式文档导入系统,通过智能分块(Chunking)、向量化(Embedding)处理后存入向量数据库(支持 Redis/Qdrant/Milvus),实现基于语义相似度的智能检索与问答。基于 Spring AI 框架实现,统一对接多种向量存储后端。
1.2 目标用户与使用频率
| 用户类型 | 使用场景 | 预计使用频率 |
|---|---|---|
| 企业知识管理者 | 构建企业知识库,沉淀组织知识资产 | 每日(管理),每周(使用) |
| 研学导师/教师 | 构建课程知识库,辅助教学问答 | 每周 3-5 次 |
| 项目经理 | 构建项目知识库,快速检索项目文档 | 每日 2-5 次 |
| 普通用户 | 通过知识库检索和智能问答获取所需信息 | 每日 3-10 次 |
| 平台运营人员 | 管理知识库、监控文档处理状态、分析使用数据 | 每日 |
| 系统管理员 | 配置向量数据库、管理知识库资源、监控系统性能 | 每周 1-2 次 |
1.3 业务价值
| 价值维度 | 具体收益 | 衡量指标 |
|---|---|---|
| 知识资产沉淀 | 将分散文档集中管理,构建结构化知识体系 | 知识库文档覆盖率 ≥ 80% |
| 智能语义检索 | 超越关键词匹配,实现真正的语义理解 | 检索命中率 ≥ 75% |
| 智能问答能力 | 知识库与 AI 结合,提供精准问答 | 问答准确率 ≥ 80% |
| 多格式支持 | PDF、Word、TXT、Markdown、HTML 全覆盖 | 支持 5 种主流文档格式 |
| 多向量库适配 | Redis/Qdrant/Milvus 适配不同规模 | 10 万分段检索 ≤ 2 秒 |
| 精细化运营 | 文档统计、检索统计、命中率统计 | 统计延迟 ≤ 5 分钟 |
| 灵活配置 | 分块策略、阈值、模型均可自定义 | 参数调整后即时生效 |
1.4 功能范围
| 功能分类 | 后台管理端 | 前台用户端 |
|---|---|---|
| 知识库管理(CRUD) | ✅ | ✅(只读) |
| 知识库配置(向量模型/分块策略/阈值) | ✅ | ❌ |
| 向量数据库配置 | ✅ | ❌ |
| 文档管理(上传/解析/删除) | ✅ | ❌ |
| 分段管理(查看/编辑/删除) | ✅ | ❌ |
| 知识库测试(问答/检索) | ✅ | ❌ |
| 知识库统计 | ✅ | ❌ |
| 知识库列表浏览 | ❌ | ✅ |
| 知识库搜索/问答 | ❌ | ✅ |
| 检索结果展示 | ❌ | ✅ |
二、用户场景
2.1 用户角色
| 角色 | 描述 | 核心诉求 |
|---|---|---|
| 知识管理者 小刘 | 企业/团队知识库负责人 | 高效导入文档、维护知识库质量、保障知识准确性 |
| 研学导师 张老师 | 课程内容创建者 | 构建课程知识库、辅助学生答疑 |
| 普通用户 小李 | 知识库使用者 | 快速找到所需信息、获得准确答案 |
| 运营人员 小陈 | 平台运营管理者 | 监控知识库健康度、分析使用情况、优化检索效果 |
| 系统管理员 小赵 | 技术管理者 | 配置向量数据库、优化系统性能、管理资源配额 |
2.2 使用场景
场景1:知识管理者小刘构建企业知识库
- 角色:知识管理者小刘
- 前置条件:小刘具有"ai:knowledge:base:create"和"ai:knowledge:document:upload"权限
- 操作流程:
- 小刘进入后台"知识库管理"页面,点击"创建知识库"
- 填写名称"产品研发知识库"、描述
- 选择向量模型 text-embedding-3-small
- 设置分块策略:块大小 512、重叠 50
- 设置相似度阈值 0.7
- 选择向量数据库为 Qdrant
- 创建成功后进入文档管理,批量上传产品需求文档、技术方案、设计文档(PDF/Word/Markdown)
- 系统自动解析、分块、向量化,小刘查看处理状态
- 全部完成后,进入"测试"标签页验证检索效果
- 期望结果:上传流程顺畅、文档解析准确、处理状态可追踪
- 验收标准:
- 知识库创建后状态为"空闲",文档上传后自动触发处理流水线
- 10MB 以内的文档在 60 秒内完成解析
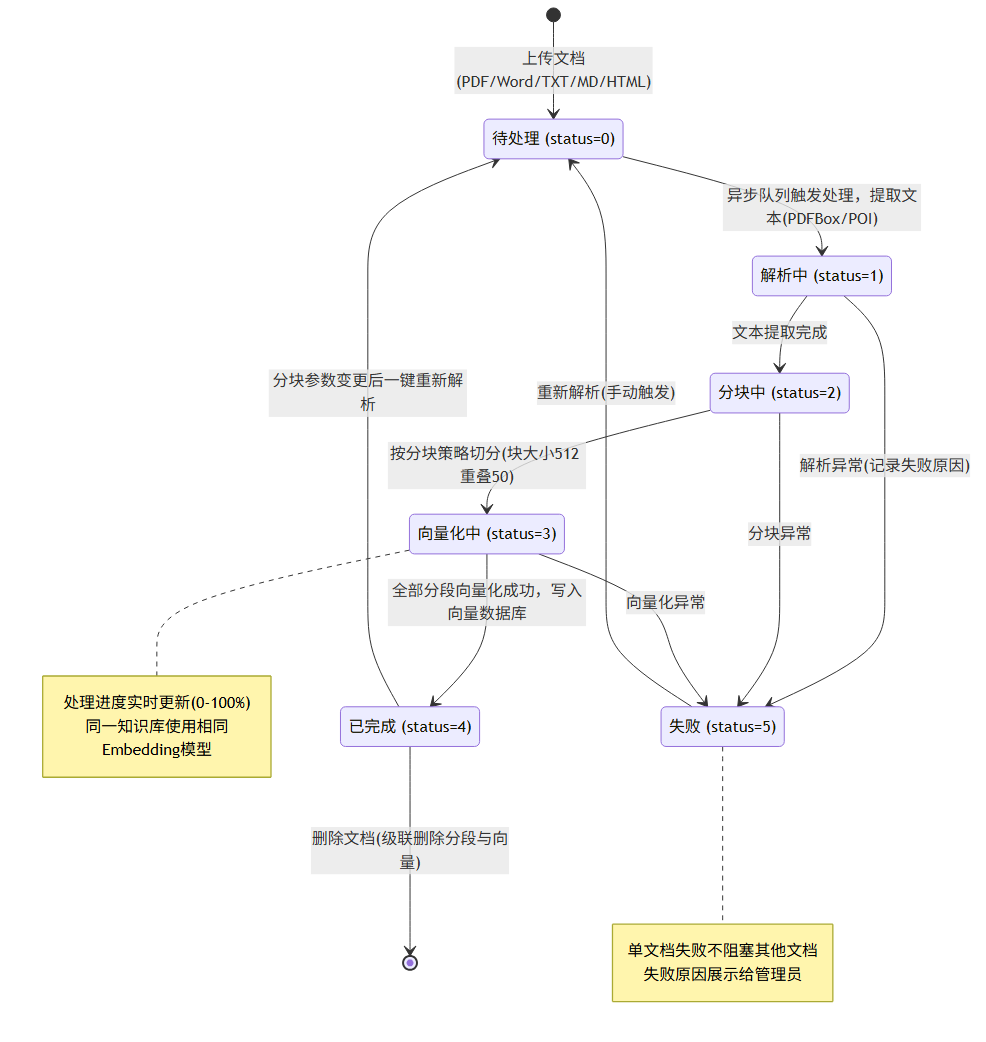
- 文档处理状态实时更新:待处理 → 解析中 → 分块中 → 向量化中 → 已完成
- 处理失败时显示具体失败原因,不影响其他文档
- 问答测试返回的答案附带引用来源(文档名+段落)
场景2:普通用户小李通过知识库智能问答
- 角色:普通用户小李
- 前置条件:小李已登录,"产品研发知识库"已创建并包含文档
- 操作流程:
- 小李在前台进入"知识库"页面
- 选择"产品研发知识库"
- 在搜索框输入"产品的 API 接口规范是什么?"
- 系统从知识库检索相关内容,结合 AI 大模型生成答案
- 展示答案并附带引用来源(具体文档名和段落)
- 小李点击引用来源查看原文上下文
- 小李点击"有帮助"反馈
- 期望结果:答案准确、引用可追溯、响应快速
- 验收标准:
- 问答响应时间 ≤ 10 秒(含 AI 生成)
- 答案附带引用来源列表,每条包含文档名、段落摘要、相似度得分
- 点击引用来源可查看分段完整内容
- 无匹配结果时友好提示"未找到相关内容"
- 反馈数据(有帮助/没帮助)被正确记录
场景3:运营人员小陈优化知识库检索效果
- 角色:运营人员小陈
- 前置条件:小陈发现"产品研发知识库"检索效果不佳
- 操作流程:
- 小陈进入"分段管理"页面,查看某文档的分段情况
- 发现分块过大导致语义不聚焦
- 调整知识库分块参数:块大小从 512 缩小到 256
- 触发已有文档重新解析
- 重新分块后进入"测试"标签页验证检索效果
- 手动编辑个别分段内容以优化质量
- 查看统计页面确认命中率提升
- 期望结果:分段可视化清晰、可灵活调整、效果可验证
- 验收标准:
- 分段列表展示序号、内容预览(前 100 字)、字数、状态
- 编辑分段内容后自动触发重新向量化
- 分块参数修改后可一键触发已有文档重新解析
- 命中率统计实时更新,可对比调整前后效果
- 删除分段后向量数据库中的对应向量同步删除
场景4:系统管理员小赵配置向量数据库
- 角色:系统管理员小赵
- 前置条件:小赵具有"ai:knowledge:vector-store:manage"权限
- 操作流程:
- 小赵进入"系统配置 → 向量数据库"页面
- 点击"新增连接",选择类型 Milvus
- 填写连接地址、端口、认证信息
- 配置集合名称和向量维度
- 保存后进行"连通性测试"
- 测试通过后,将目标知识库的向量存储切换到 Milvus
- 验证检索效果
- 期望结果:切换平滑、数据不丢失、性能提升明显
- 验收标准:
- 连通性测试在 5 秒内返回结果
- 密码字段加密存储,日志中不打印密码
- 删除连接前系统检查是否有知识库正在使用,有则阻止删除
- 向量维度与 Embedding 模型匹配,不匹配时提示错误
- 支持 Redis、Qdrant、Milvus 三种类型
场景5:研学导师张老师构建课程知识库辅助教学
- 角色:研学导师张老师
- 前置条件:张老师已登录,需要为"中国古代史"课程构建知识库
- 操作流程:
- 张老师创建知识库"中国古代史课程"
- 上传课程教材 PDF、补充资料 Word、课堂笔记 Markdown
- 等待文档处理完成
- 学生在前台进入该知识库,提问"唐朝的科举制度是怎样的?"
- 系统检索知识库内容,生成答案并标注教材出处
- 张老师查看统计,了解学生高频问题
- 期望结果:知识库覆盖课程内容,学生问答准确
- 验收标准:
- 批量上传支持一次最多 10 个文件
- 单文件最大 50MB
- 学生问答结果引用到具体教材段落
- 高频问题 Top 20 可在统计页面查看
- 问答模式消耗 Token,检索模式不消耗
三、功能需求
3.1 知识库管理(后台管理端)
描述
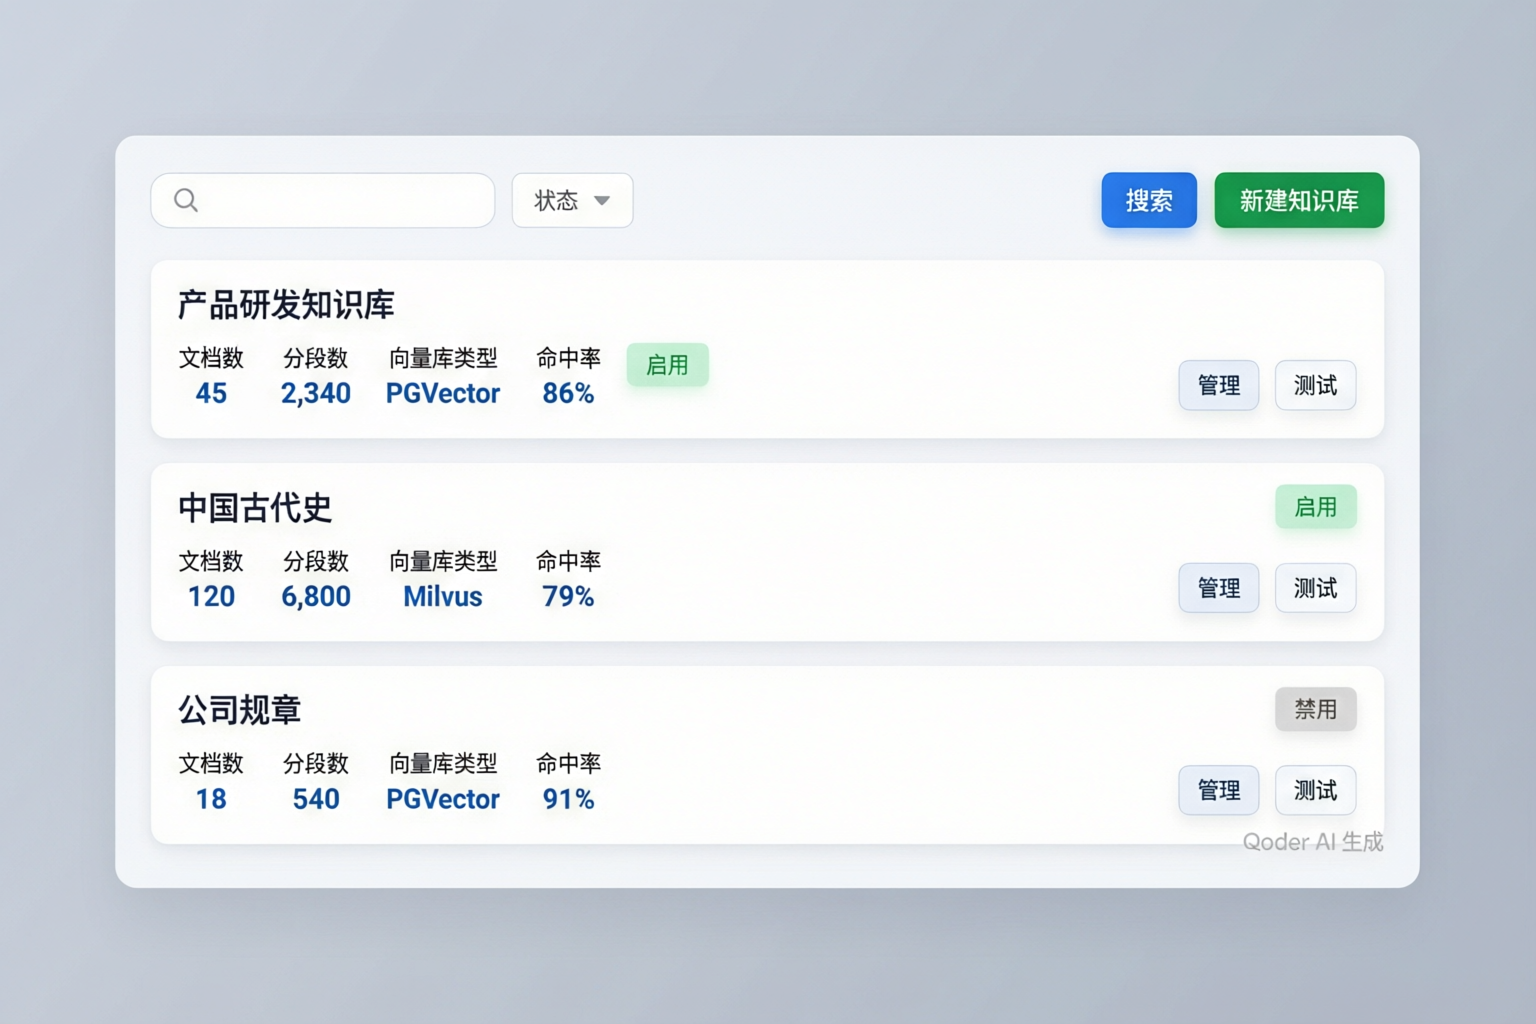
管理平台内所有知识库的创建、编辑、删除、配置等操作。每个知识库是一个独立的知识容器,拥有独立的文档集合、向量数据和配置参数。
页面原型:知识库管理列表页
操作流程
- 管理员进入"知识库管理"页面
- 查看知识库列表,展示名称、描述、文档数、分段数、状态、创建时间
- 支持按名称搜索、按状态筛选
- 点击"创建知识库"进入创建流程:
- 填写基本信息:名称、描述
- 配置参数:向量模型、分块大小、分块重叠、相似度阈值
- 选择向量数据库:Redis/Qdrant/Milvus
- 保存后知识库状态为"空闲"(无文档)
- 支持对已有知识库进行编辑、删除、启用/禁用操作
- 删除知识库时级联删除所有文档、分段和向量数据
业务规则
| 规则 | 说明 | 设计原因 |
|---|---|---|
| 名称唯一 | 知识库名称不可重复(同租户内) | 避免混淆,方便引用 |
| 逻辑删除 | 知识库删除为逻辑删除,数据保留 30 天 | 防止误删,提供恢复窗口 |
| 二次确认 | 删除知识库前需二次确认 | 级联删除影响大,需防止误操作 |
| 配置变更需重索引 | 向量数据库配置变更后需重新索引已有文档 | 向量存储后端变更,数据需迁移 |
| 分块参数变更需重解析 | 分块参数修改后需触发已有文档重新解析 | 分块策略改变,分段需重新切分 |
| 相似度阈值范围 | 0.0-1.0,默认 0.7 | 0.7 是经验值,平衡召回率和精确率 |
| 分块大小范围 | 100-2000,默认 512 | 512 字符是语义完整性和检索精度的平衡点 |
| 分块重叠范围 | 0-500,默认 50 | 重叠防止语义在切分边界被截断 |
接口列表
| 接口名称 | 请求方式 | 接口路径 | 说明 |
|---|---|---|---|
| 查询知识库分页列表 | GET | /admin-api/ai/knowledge/base/list | 支持名称搜索、状态筛选 |
| 查询知识库详情 | GET | /admin-api/ai/knowledge/base/ | 获取知识库完整信息 |
| 创建知识库 | POST | /admin-api/ai/knowledge/base/create | 创建新知识库 |
| 修改知识库 | PUT | /admin-api/ai/knowledge/base/update | 更新知识库信息和配置 |
| 删除知识库 | DELETE | /admin-api/ai/knowledge/base/delete/ | 逻辑删除知识库及关联数据 |
| 启用/禁用知识库 | PUT | /admin-api/ai/knowledge/base/status/ | 切换知识库状态 |
| 获取知识库下拉 | GET | /admin-api/ai/knowledge/base/options | 用于前端下拉选择 |
| 获取向量模型列表 | GET | /admin-api/ai/knowledge/base/embedding-models | 可用向量模型列表 |
| 获取向量数据库列表 | GET | /admin-api/ai/knowledge/base/vector-stores | 可用向量数据库列表 |
3.2 文档管理(后台管理端)
描述
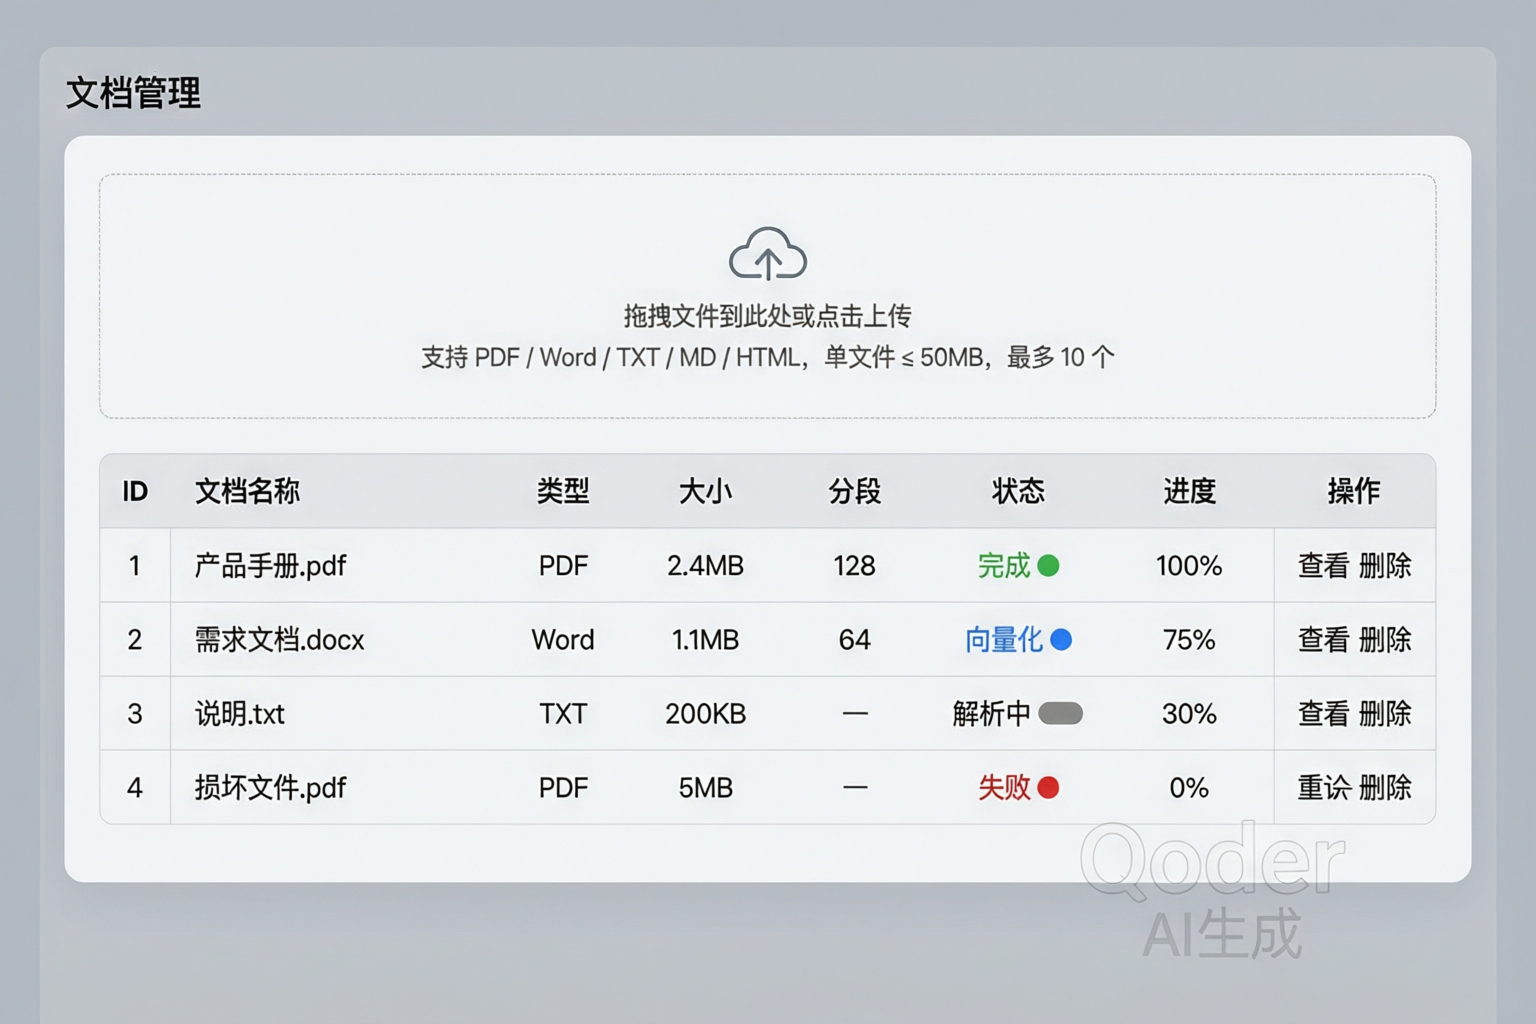
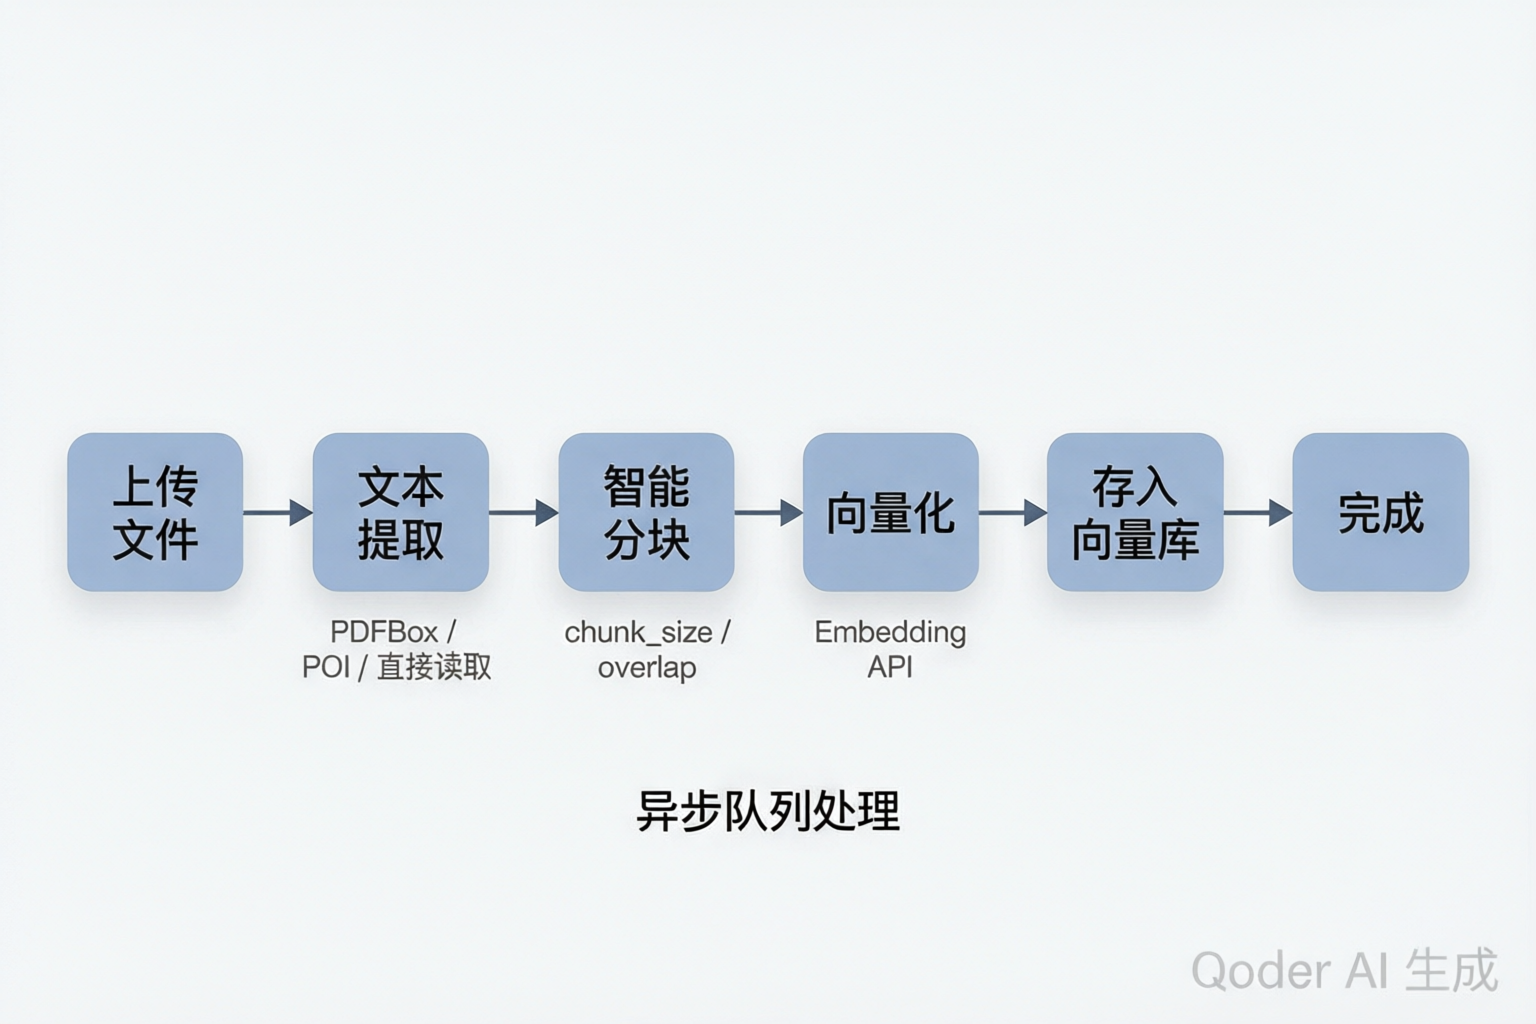
管理知识库内的文档,支持文档上传、解析状态查看、删除、重新解析等操作。系统自动完成文档解析、文本提取、智能分块、向量化等处理流程。
页面原型:文档管理页面
文档处理流水线
文档处理状态机
业务规则
| 规则 | 说明 | 设计原因 |
|---|---|---|
| 单文件大小限制 | 50MB | 平衡功能需求与服务器资源 |
| 批量上传限制 | 单次最多 10 个文件 | 避免并发处理压力过大 |
| 文档数量上限 | 单知识库 500 个(可配置) | 控制单知识库规模,过大建议拆分 |
| 异步处理 | 文档处理采用异步队列 | 避免阻塞用户操作,大文档处理耗时较长 |
| 统一 Embedding | 同一知识库内的向量使用相同的 Embedding 模型 | 不同模型的向量空间不兼容,不可混用 |
| 格式适配 | PDF 用 PDFBox,Word 用 POI,其他直接读取 | 各格式解析方式不同,选用成熟开源库 |
| 失败不阻塞 | 处理失败不阻塞其他文档 | 单文档失败不应影响整体知识库可用性 |
| 级联删除 | 删除文档后级联删除所有分段和向量数据 | 保持数据一致性 |
接口列表
| 接口名称 | 请求方式 | 接口路径 | 说明 |
|---|---|---|---|
| 查询文档分页列表 | GET | /admin-api/ai/knowledge/document/list | 按知识库 ID 筛选 |
| 查询文档详情 | GET | /admin-api/ai/knowledge/document/ | 获取文档详情 |
| 上传文档 | POST | /admin-api/ai/knowledge/document/upload | 上传文档文件(支持批量) |
| 删除文档 | DELETE | /admin-api/ai/knowledge/document/delete/ | 逻辑删除文档及分段 |
| 重新解析文档 | POST | /admin-api/ai/knowledge/document/reparse/ | 使用当前参数重新处理 |
| 批量删除文档 | DELETE | /admin-api/ai/knowledge/document/batch-delete | 批量逻辑删除 |
| 查询文档处理进度 | GET | /admin-api/ai/knowledge/document/{id}/progress | 获取处理进度百分比 |
3.3 分段管理(后台管理端)
描述
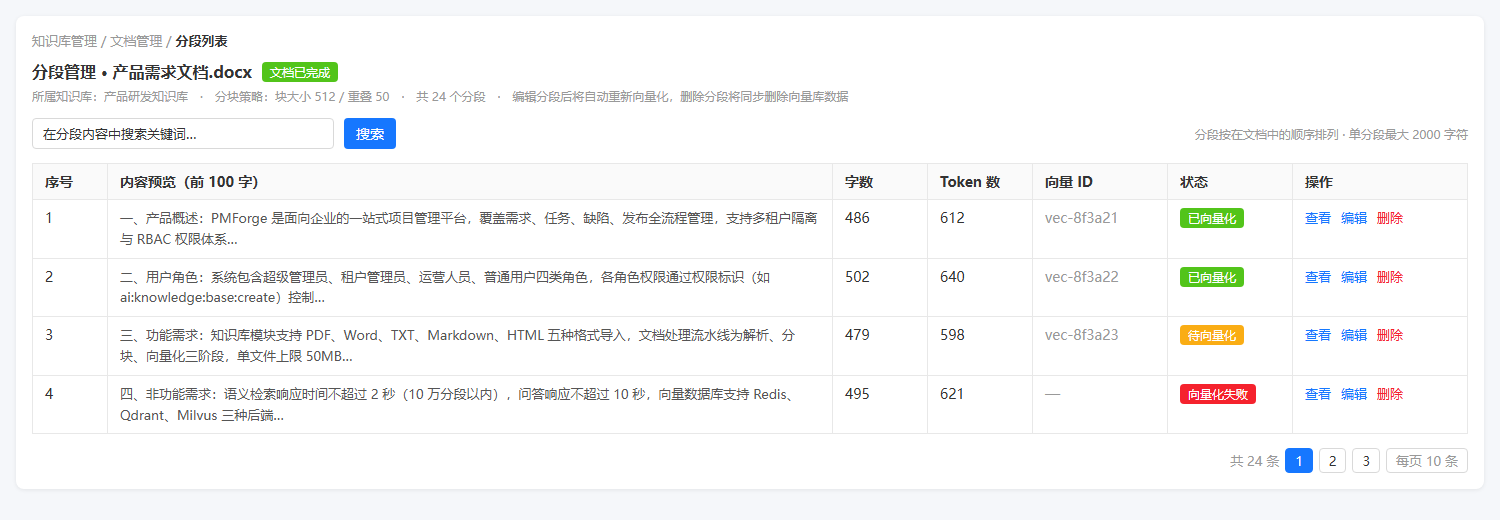
管理知识库文档的智能分段结果。每个文档根据分块策略被切分为多个分段(Segment),每个分段包含文本内容和对应的向量表示。支持查看、编辑、删除分段。
页面原型:分段管理页面
操作流程
- 在文档列表中点击某文档的"查看分段"
- 进入分段列表页面,展示该文档所有分段
- 分段列表展示:序号、内容预览(前 100 字)、字数、Token 数、状态
- 点击分段可展开查看完整内容
- 支持对分段进行:
- 编辑:修改分段文本内容(修改后自动重新向量化)
- 删除:删除单个分段(从向量库中同步删除)
- 支持分段内容搜索(在分段列表中搜索关键词)
业务规则
| 规则 | 说明 | 设计原因 |
|---|---|---|
| 编辑后重新向量化 | 分段内容编辑后需自动触发重新向量化 | 文本变了,向量必须更新,否则检索不准 |
| 删除同步向量库 | 删除分段后同步删除向量数据库中的对应向量 | 保持数据库与向量库一致性 |
| 长度上限 | 分段内容最大长度不超过 2000 字符 | 与分块大小上限一致 |
| 顺序排列 | 分段按在文档中的顺序排列 | 方便管理员定位和查阅 |
| 向量 ID 关联 | 每个分段记录对应的向量 ID | 用于精确操作向量库中的对应向量 |
接口列表
| 接口名称 | 请求方式 | 接口路径 | 说明 |
|---|---|---|---|
| 查询分段分页列表 | GET | /admin-api/ai/knowledge/segment/list | 按文档 ID 筛选 |
| 查询分段详情 | GET | /admin-api/ai/knowledge/segment/ | 获取分段完整内容 |
| 编辑分段内容 | PUT | /admin-api/ai/knowledge/segment/update/ | 修改分段文本 |
| 删除分段 | DELETE | /admin-api/ai/knowledge/segment/delete/ | 删除分段及向量 |
| 分段内容搜索 | GET | /admin-api/ai/knowledge/segment/search | 在分段中搜索关键词 |
3.4 知识库测试(后台管理端)
描述
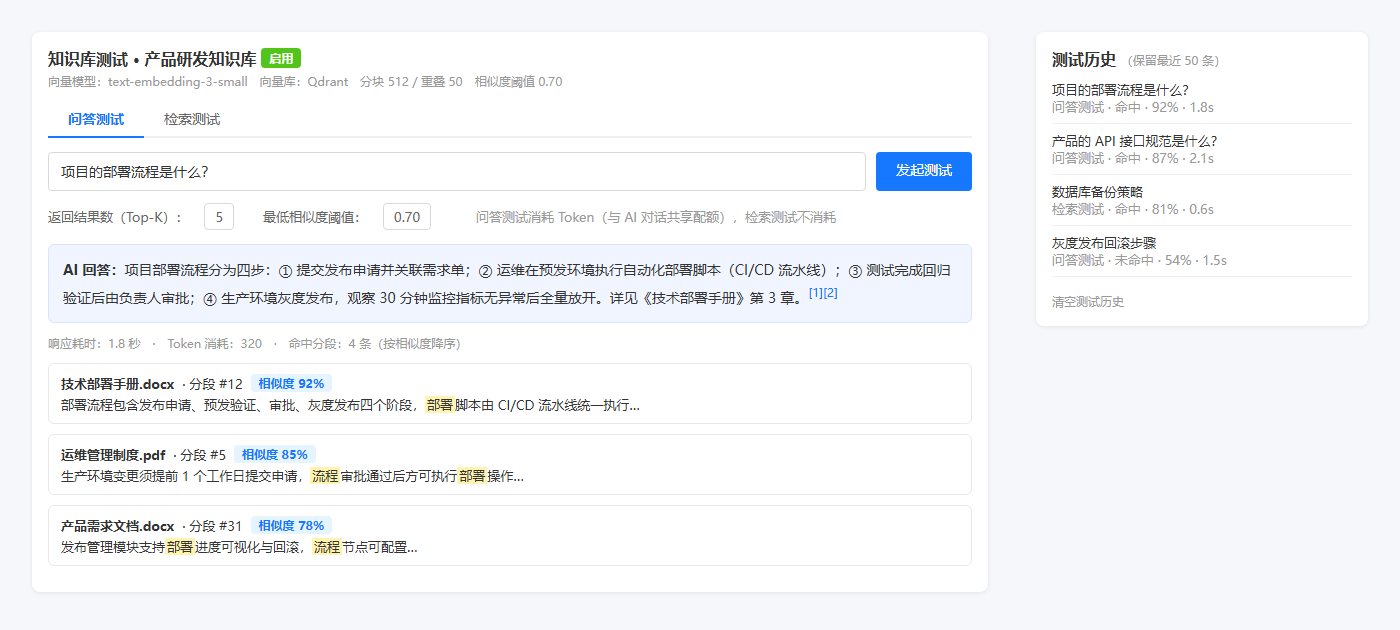
提供知识库的问答测试和相似度检索测试功能,帮助管理员验证知识库的检索效果和内容质量。
页面原型:知识库测试页面
操作流程
问答测试:
- 进入知识库详情 → "测试"标签页
- 选择"问答测试"模式
- 输入测试问题,如"项目的部署流程是什么?"
- 系统从知识库检索相关内容 → 结合 AI 大模型生成答案
- 展示结果包含:
- AI 生成的答案
- 引用的知识库分段(来源文档名 + 内容片段)
- 相似度得分
- 响应耗时
相似度检索测试:
- 选择"检索测试"模式
- 输入查询文本
- 设置返回结果数量(Top-K,默认 5)
- 设置最低相似度阈值
- 系统返回匹配的 Top-K 分段列表
- 每条结果展示:内容、相似度得分、来源文档、分段位置
业务规则
| 规则 | 说明 | 设计原因 |
|---|---|---|
| 问答消耗 Token | 问答测试消耗 Token(与 AI 对话共享配额) | 问答调用大模型,有实际成本 |
| 检索不消耗 | 检索测试不消耗 Token | 仅做向量匹配,无大模型调用成本 |
| 答案附引用 | 问答测试的答案附带引用来源 | 便于验证答案准确性,增强可信度 |
| 降序排列 | 检索结果按相似度得分降序排列 | 最相关的结果优先展示 |
| 历史保留 | 测试历史记录保留最近 50 条 | 方便回溯对比,同时避免数据膨胀 |
接口列表
| 接口名称 | 请求方式 | 接口路径 | 说明 |
|---|---|---|---|
| 知识库问答测试 | POST | /admin-api/ai/knowledge/test/chat | 基于知识库的问答测试 |
| 相似度检索测试 | POST | /admin-api/ai/knowledge/test/retrieval | 语义相似度检索测试 |
| 查询测试历史 | GET | /admin-api/ai/knowledge/test/history | 获取测试历史记录 |
| 清除测试历史 | DELETE | /admin-api/ai/knowledge/test/history | 清空测试历史 |
3.5 知识库统计(后台管理端)
描述
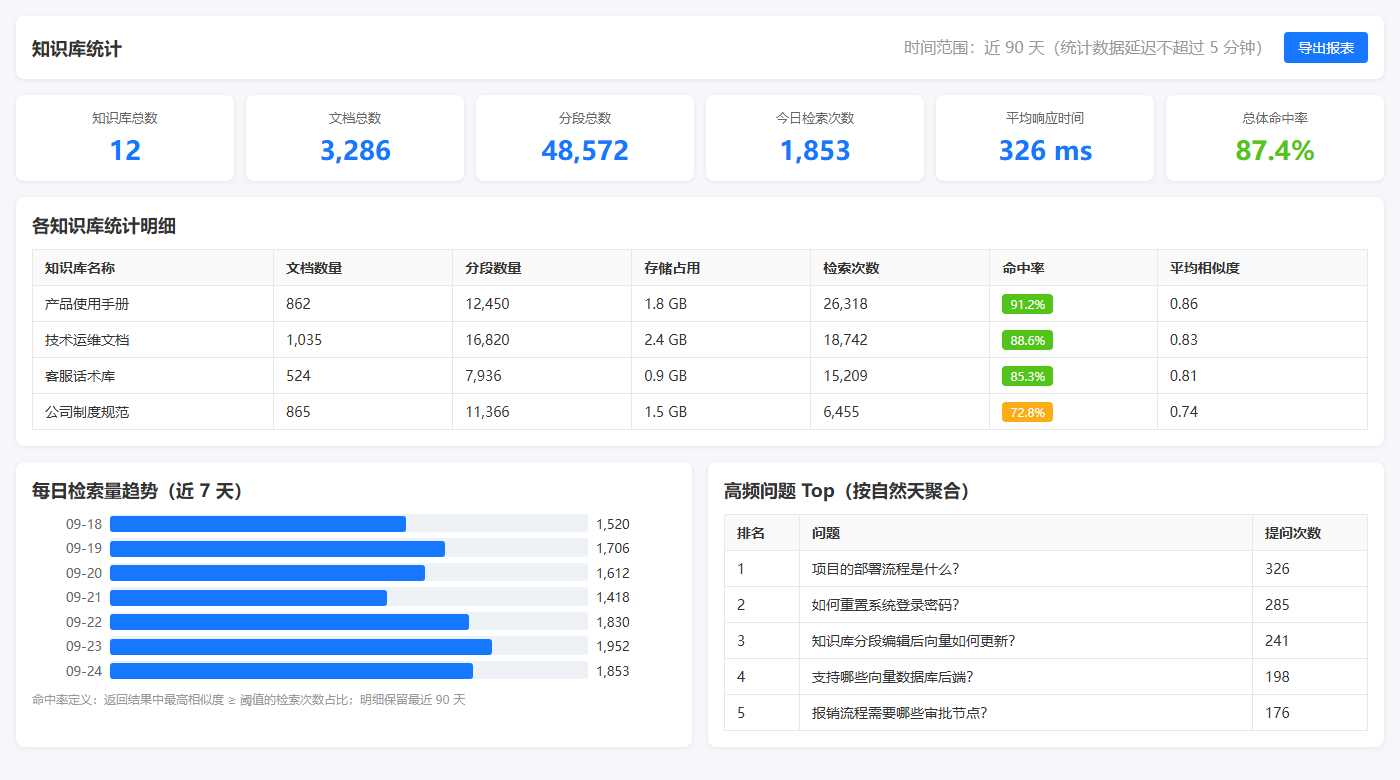
提供知识库模块的数据统计能力,包括文档统计、检索统计、命中率统计等。
页面原型:知识库统计页面
操作流程
- 管理员进入"知识库统计"页面
- 查看概览面板:知识库总数、文档总数、分段总数、今日检索次数、平均响应时间、总体命中率
- 查看各知识库详细统计:文档数量、分段数量、存储占用、检索次数、命中率、平均相似度
- 查看趋势图:每日检索量趋势、命中率趋势、新增文档量趋势
- 查看高频问题 Top 20
业务规则
| 规则 | 说明 | 设计原因 |
|---|---|---|
| 近实时统计 | 统计数据延迟不超过 5 分钟 | 运营需要及时了解知识库使用情况 |
| 命中率定义 | 返回结果中最高相似度 ≥ 阈值的检索次数占比 | 衡量知识库内容覆盖度 |
| 多维度统计 | 支持按租户、按知识库维度统计 | 不同角色关注不同维度 |
| 90 天保留 | 统计数据保留最近 90 天明细 | 平衡存储成本与趋势分析需求 |
| 高频问题聚合 | 高频问题按自然天聚合 | 反映用户关注热点 |
接口列表
| 接口名称 | 请求方式 | 接口路径 | 说明 |
|---|---|---|---|
| 获取概览数据 | GET | /admin-api/ai/knowledge/statistics/overview | 总体概览数据 |
| 获取知识库统计 | GET | /admin-api/ai/knowledge/statistics/by-base | 各知识库统计明细 |
| 获取检索趋势 | GET | /admin-api/ai/knowledge/statistics/retrieval-trend | 检索量趋势图数据 |
| 获取命中率趋势 | GET | /admin-api/ai/knowledge/statistics/hit-rate-trend | 命中率趋势图数据 |
| 获取高频问题 | GET | /admin-api/ai/knowledge/statistics/top-questions | 高频问题排行 |
| 获取文档统计 | GET | /admin-api/ai/knowledge/statistics/documents | 文档数量分布统计 |
3.6 向量数据库配置(后台管理端)
描述
管理系统支持的向量数据库连接配置,支持 Redis、Qdrant、Milvus 三种向量存储后端。管理员可添加、测试、管理向量数据库连接。
三种向量数据库对比
特性 Redis Qdrant Milvus 适用规模 小(≤ 10 万分段) 中(10-100 万) 大(100 万+) 部署复杂度 低(已有 Redis 实例) 中 高 协议 TCP HTTP / gRPC gRPC 特点 利用现有 Redis 基础设施 专为向量搜索设计,性能优秀 支持分布式,适合海量数据
操作流程
- 管理员进入"系统配置 → 向量数据库"页面
- 查看已配置的向量数据库连接列表
- 点击"新增连接"填写连接信息:
- 选择类型:Redis / Qdrant / Milvus
- 填写连接地址、端口、认证信息
- 配置连接池参数
- 保存后进行"连通性测试"
- 测试通过后该连接可被知识库选用
业务规则
| 规则 | 说明 | 设计原因 |
|---|---|---|
| Redis 用 RediSearch | Redis 向量数据库使用 RediSearch 模块 | RediSearch 提供向量索引能力 |
| Qdrant 双协议 | Qdrant 支持 HTTP 和 gRPC 两种协议 | gRPC 性能更好,HTTP 便于调试 |
| Milvus 集合配置 | Milvus 需配置集合名称和维度 | 不同知识库可使用不同集合 |
| 维度匹配 | 向量维度需与 Embedding 模型匹配 | 维度不匹配无法计算相似度 |
| 密码加密 | 连接信息中的密码字段加密存储 | 安全要求 |
| 使用检查 | 删除连接前需确认无知识库正在使用 | 防止删除后知识库不可用 |
接口列表
| 接口名称 | 请求方式 | 接口路径 | 说明 |
|---|---|---|---|
| 查询向量数据库列表 | GET | /admin-api/ai/knowledge/vector-store/list | 获取已配置列表 |
| 新增向量数据库 | POST | /admin-api/ai/knowledge/vector-store/create | 添加新连接 |
| 修改向量数据库 | PUT | /admin-api/ai/knowledge/vector-store/update | 更新连接配置 |
| 删除向量数据库 | DELETE | /admin-api/ai/knowledge/vector-store/delete/ | 删除连接配置 |
| 连通性测试 | POST | /admin-api/ai/knowledge/vector-store/test/ | 测试连接可用性 |
3.7 知识库列表(前台用户端)
描述
用户在前台查看可访问的知识库列表,了解各知识库的基本信息和文档概况。
操作流程
- 用户进入"知识库"页面
- 查看可用知识库列表(仅展示已启用且有文档的知识库)
- 每个知识库卡片展示:名称、描述、文档数、最近更新
- 点击知识库卡片进入搜索/问答页面
业务规则
| 规则 | 说明 | 设计原因 |
|---|---|---|
| 仅展示启用状态 | 仅展示状态为"启用"的知识库 | 禁用的知识库不应被用户使用 |
| 有文档才展示 | 仅展示至少有一个已完成解析文档的知识库 | 空知识库无法检索,展示无意义 |
| 最近更新排序 | 按最近更新时间排序 | 活跃的知识库优先展示 |
| 名称搜索 | 支持按名称搜索 | 知识库较多时快速定位 |
接口列表
| 接口名称 | 请求方式 | 接口路径 | 说明 |
|---|---|---|---|
| 查询知识库列表 | GET | /app-api/ai/knowledge/base/list | 获取可用知识库 |
| 查询知识库详情 | GET | /app-api/ai/knowledge/base/ | 获取知识库基本信息 |
3.8 知识库搜索/问答(前台用户端)
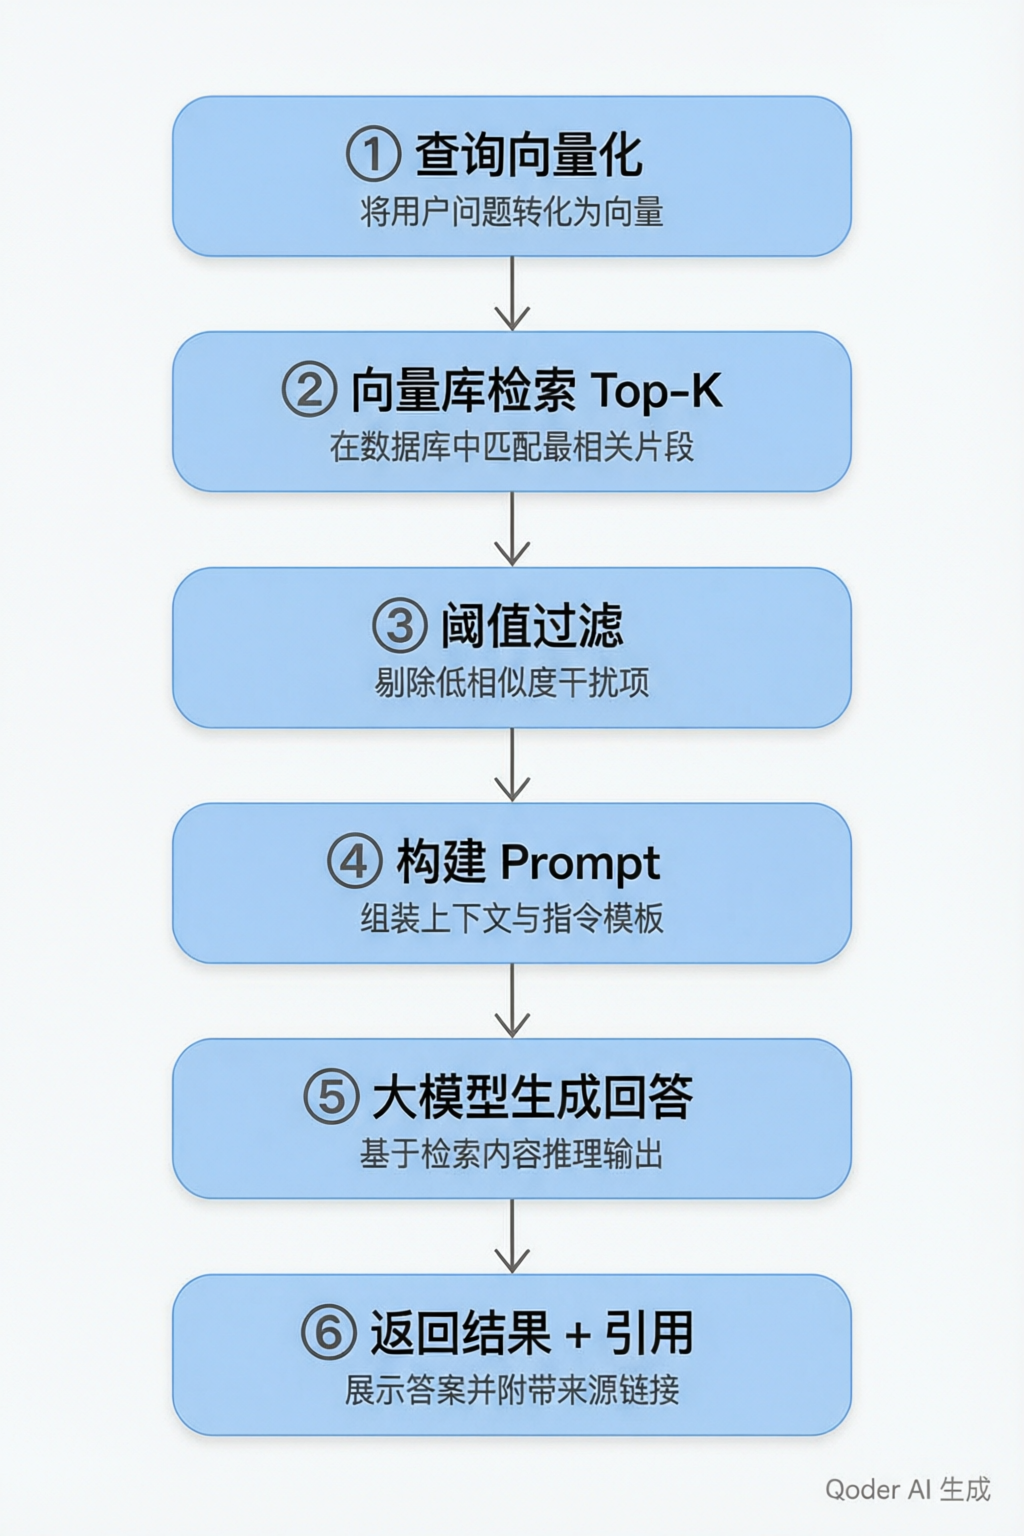
描述
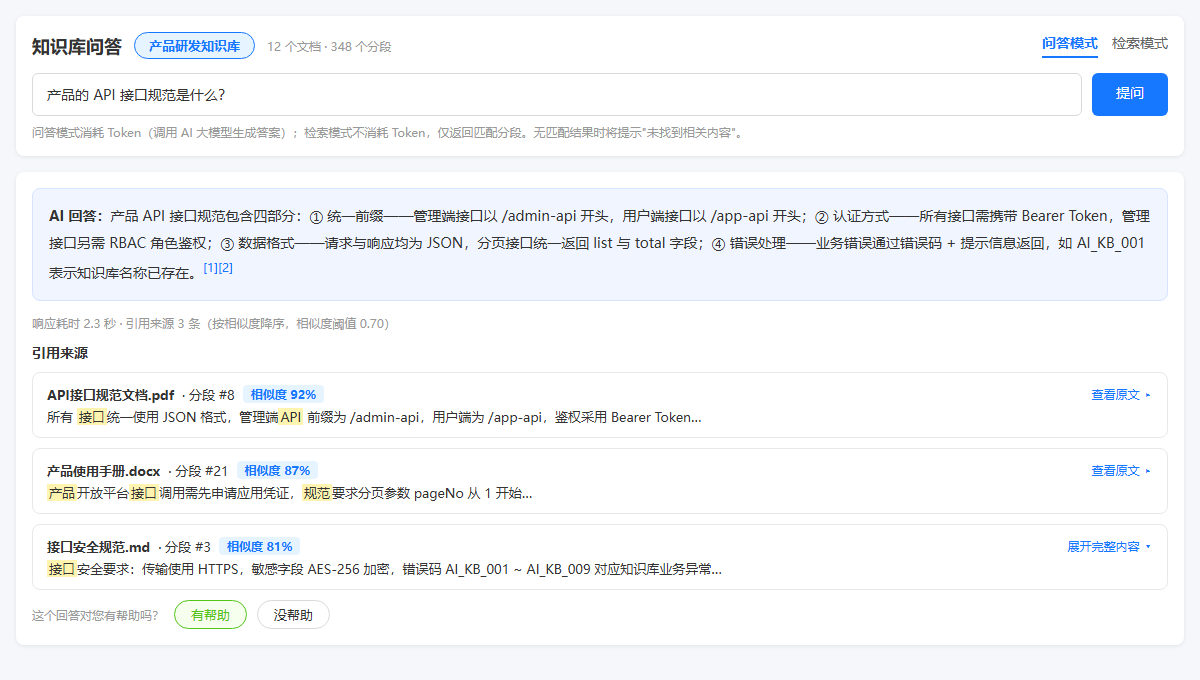
用户在前台通过自然语言对知识库进行搜索或问答,系统基于语义检索匹配相关内容并结合 AI 大模型生成回答。
页面原型:知识库问答页面
RAG 检索流程
业务规则
| 规则 | 说明 | 设计原因 |
|---|---|---|
| 问答消耗 Token | 问答模式消耗 Token | 调用大模型有实际成本 |
| 检索不消耗 | 检索模式不消耗 Token(仅返回匹配分段) | 仅做向量匹配,无大模型调用 |
| Top-K 可配置 | 默认返回 5 条结果,可配置 1-10 | 5 条是精确率和召回率的平衡点 |
| 阈值取配置 | 相似度阈值取知识库配置值 | 每个知识库可设定不同的精确度要求 |
| 无结果友好提示 | 无匹配结果时友好提示"未找到相关内容" | 用户体验,避免空白页面 |
| 引用可追溯 | 回答附带引用来源,每条引用可点击查看原文 | 增强可信度,用户可验证答案 |
| 反馈优化 | 用户反馈数据用于优化检索效果 | 持续改进检索质量 |
接口列表
| 接口名称 | 请求方式 | 接口路径 | 说明 |
|---|---|---|---|
| 知识库问答 | POST | /app-api/ai/knowledge/chat | 基于知识库的智能问答 |
| 知识库检索 | POST | /app-api/ai/knowledge/retrieval | 语义检索(不生成答案) |
| 查看引用原文 | GET | /app-api/ai/knowledge/reference/ | 查看引用分段原文上下文 |
| 提交反馈 | POST | /app-api/ai/knowledge/feedback | 对回答提交有帮助/没帮助反馈 |
3.9 检索结果展示(前台用户端)
描述
对知识库检索和问答结果进行结构化展示,包含 AI 回答、引用来源、相似度得分等信息,支持用户深入了解检索依据。
操作流程
- 问答/检索结果页面展示:
- 顶部:AI 回答内容(问答模式)或匹配分段列表(检索模式)
- 底部:引用来源列表
- 每条引用来源展示:
- 来源文档名称
- 相关段落摘要(高亮匹配关键词)
- 相似度得分(百分比展示)
- 点击展开查看完整分段内容
- 用户可点击"查看原文"跳转到文档原文位置
业务规则
| 规则 | 说明 | 设计原因 |
|---|---|---|
| 降序排列 | 引用来源按相似度得分降序排列 | 最相关的优先展示 |
| 百分比展示 | 相似度得分以百分比形式展示(如"87%") | 比小数更直观 |
| 关键词高亮 | 匹配关键词在摘要中高亮显示 | 帮助用户快速定位相关内容 |
| 完整内容可展开 | 展开分段内容时显示完整文本 | 摘要不够时可查看完整上下文 |
| 视图切换 | 检索结果支持切换列表视图/卡片视图 | 不同用户偏好不同展示方式 |
接口列表
| 接口名称 | 请求方式 | 接口路径 | 说明 |
|---|---|---|---|
| 获取分段完整内容 | GET | /app-api/ai/knowledge/segment/{id}/full | 获取分段完整文本 |
| 获取文档原文 | GET | /app-api/ai/knowledge/document/{id}/content | 获取文档原始文本 |
四、非功能需求
4.1 性能需求
| 指标 | 要求 | 实现策略 |
|---|---|---|
| 文档上传响应时间 | ≤ 500ms(不含处理时间) | 上传仅存储文件,处理异步进行 |
| 单文档解析时间(10MB 以内) | ≤ 60 秒 | 异步队列处理,消息驱动 |
| 向量化处理速度 | ≥ 100 分段/分钟 | 批量调用 Embedding API,减少网络开销 |
| 语义检索响应时间 | ≤ 2 秒(10 万分段以内) | 向量数据库 ANN 索引加速 |
| 问答响应时间 | ≤ 10 秒(含 AI 生成) | 检索 + 大模型生成并行优化 |
| 向量数据库查询 | ≤ 500ms | 向量索引预构建,内存缓存热点数据 |
| 单知识库分段数上限 | 100 万条 | 超过建议拆分或升级向量数据库 |
| 并发检索处理能力 | ≥ 100 次/秒 | 向量数据库连接池 + 读写分离 |
| 统计报表生成时间 | ≤ 5 秒 | 预计算 + 缓存 |
4.2 安全需求
| 安全项 | 要求 | 实现方式 |
|---|---|---|
| 数据隔离 | 多租户数据严格隔离,知识库级别隔离 | MyBatis Plus 租户插件 + 向量数据库 namespace 隔离 |
| 接口鉴权 | 所有接口需登录鉴权,管理接口需角色鉴权 | Spring Security + RBAC 权限体系 |
| 文件安全 | 上传文件需进行病毒扫描和格式校验 | 文件类型白名单 + 文件头校验 |
| 内容安全 | 检索结果需经内容安全过滤 | 接入内容安全审核接口 |
| 密码加密 | 向量数据库密码 AES-256 加密存储 | 框架统一加密组件 |
| 文件存储安全 | 上传文件存储于安全存储,URL 带签名 | 对象存储签名 URL |
| 操作审计 | 知识库的增删改操作记录审计日志 | AOP 审计日志切面 |
| 传输加密 | 向量数据库连接支持 TLS/SSL | 配置证书和加密传输 |
4.3 可用性需求
| 指标 | 要求 |
|---|---|
| 服务可用率 | ≥ 99.5% |
| 文档处理容错 | 单文档处理失败不影响其他文档和知识库 |
| 向量库降级 | 向量数据库不可用时,检索功能降级提示 |
| 数据备份 | 向量数据每日增量备份,关系数据全量备份 |
4.4 错误码定义
| 错误码 | 说明 | 处理建议 |
|---|---|---|
| AI_KB_001 | 知识库名称已存在 | 提示用户更换名称 |
| AI_KB_002 | 文件格式不支持 | 提示支持的格式列表(PDF/DOCX/TXT/MD/HTML) |
| AI_KB_003 | 文件大小超过限制 | 提示最大 50MB,建议压缩后上传 |
| AI_KB_004 | 文档数量超过上限 | 提示单知识库最多 500 个文档 |
| AI_KB_005 | 文档解析失败 | 显示具体失败原因,建议检查文件完整性 |
| AI_KB_006 | 向量数据库连接失败 | 提示检查连接配置和网络 |
| AI_KB_007 | 向量维度不匹配 | 提示更换向量模型或调整维度配置 |
| AI_KB_008 | 知识库正在使用中,无法删除 | 提示先解除关联的知识库引用 |
| AI_KB_009 | 检索超时 | 提示缩小检索范围或联系管理员优化 |
五、数据设计
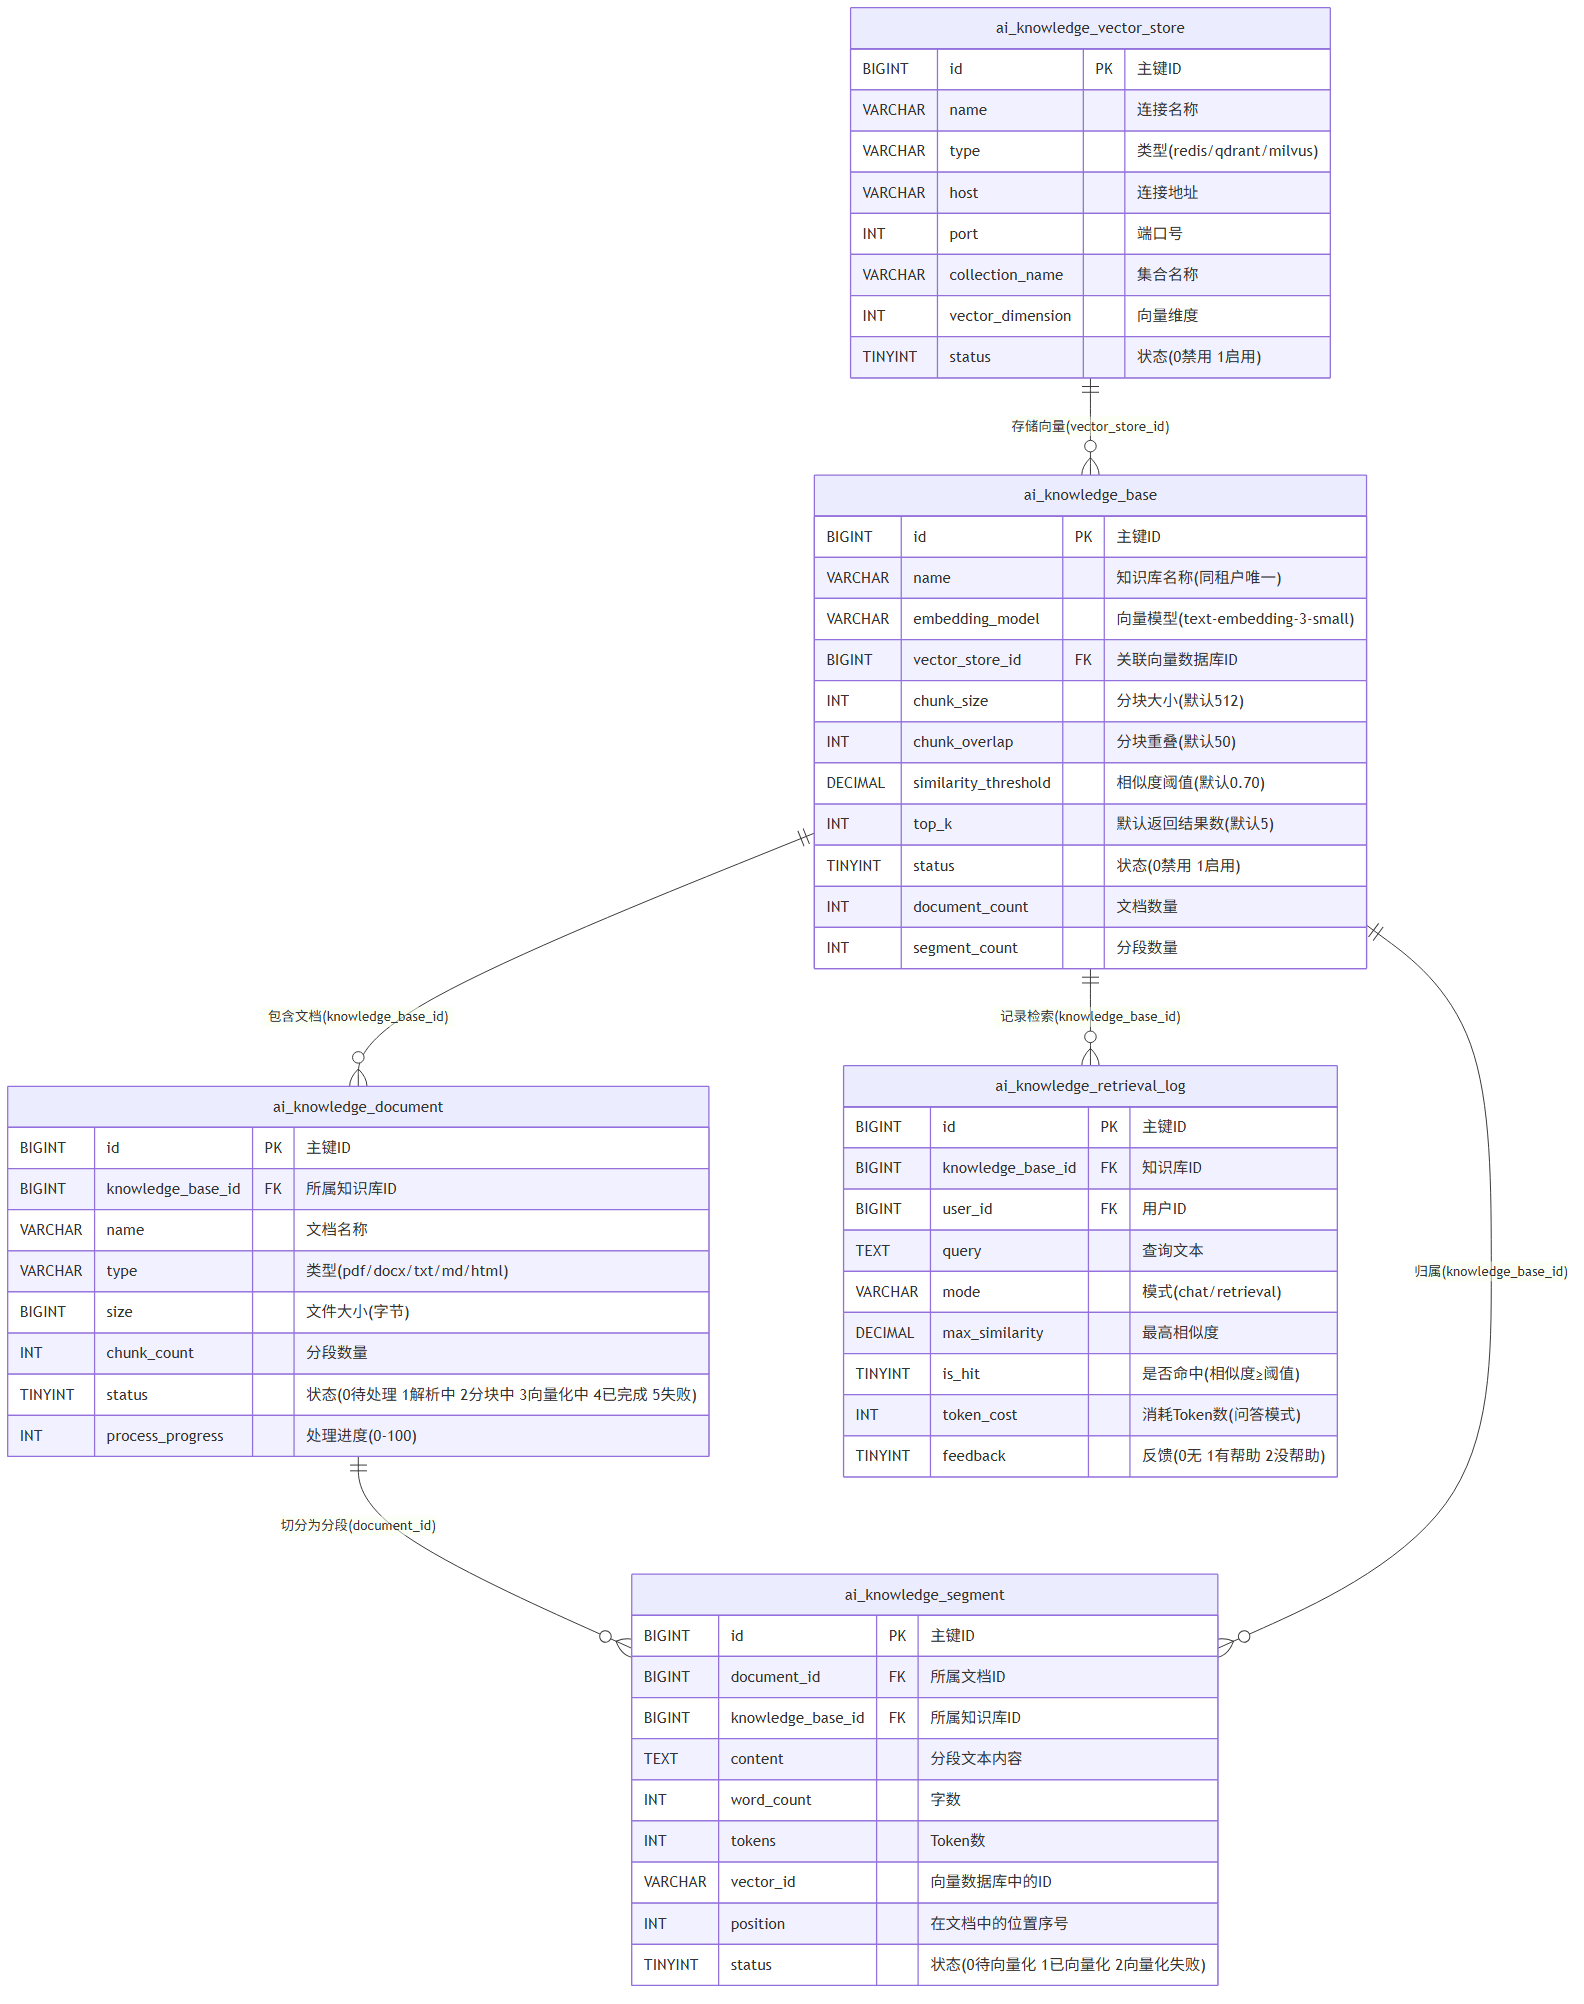
5.1 数据表概览
| 表名 | 说明 | 核心字段 |
|---|---|---|
| ai_knowledge_base | 知识库表 | name, embedding_model, vector_store_id, chunk_size, similarity_threshold |
| ai_knowledge_document | 文档表 | knowledge_base_id, name, type, url, status, chunk_count |
| ai_knowledge_segment | 分段表 | document_id, content, vector_id, position, status |
| ai_knowledge_retrieval_log | 检索日志表 | knowledge_base_id, query, mode, max_similarity, is_hit |
| ai_knowledge_vector_store | 向量数据库配置表 | name, type, host, port, password, vector_dimension |
5.2 表关系
5.3 缓存策略
| 缓存 Key | 数据内容 | 过期时间 | 更新策略 |
|---|---|---|---|
| ai:kb:base:list | 启用状态的知识库列表 | 30 分钟 | 知识库变更时主动失效 |
| ai:kb:base:config: | 知识库配置参数 | 30 分钟 | 配置变更时主动失效 |
| ai:kb:vector-store:list | 向量数据库连接列表 | 1 小时 | 配置变更时主动失效 |
| ai:kb:doc:progress: | 文档处理进度 | 5 分钟 | 处理过程中实时更新 |
| ai:kb:stats:overview | 统计概览数据 | 5 分钟 | 定时刷新 |
5.4 核心数据表结构
ai_knowledge_base 知识库表
| 字段名 | 字段类型 | 是否必填 | 说明 |
|---|---|---|---|
| id | BIGINT | 是 | 主键 ID |
| name | VARCHAR(100) | 是 | 知识库名称 |
| description | VARCHAR(500) | 否 | 知识库描述 |
| embedding_model | VARCHAR(100) | 是 | 向量模型名称(如 text-embedding-3-small) |
| vector_dimension | INT | 是 | 向量维度(与模型匹配) |
| vector_store_id | BIGINT | 是 | 关联向量数据库 ID |
| vector_store_type | VARCHAR(30) | 是 | 向量数据库类型(redis/qdrant/milvus) |
| chunk_size | INT | 是 | 分块大小(字符数),默认 512 |
| chunk_overlap | INT | 是 | 分块重叠大小(字符数),默认 50 |
| similarity_threshold | DECIMAL(3,2) | 是 | 相似度阈值(0.00-1.00),默认 0.70 |
| top_k | INT | 否 | 默认返回结果数量,默认 5 |
| status | TINYINT | 是 | 状态(0 禁用 1 启用) |
| document_count | INT | 否 | 文档数量(冗余计数) |
| segment_count | INT | 否 | 分段数量(冗余计数) |
| total_size | BIGINT | 否 | 文档总大小(字节) |
| retrieval_count | BIGINT | 否 | 累计检索次数 |
| hit_count | BIGINT | 否 | 命中次数(相似度 ≥ 阈值) |
| creator | VARCHAR(64) | 否 | 创建者 |
| create_time | DATETIME | 否 | 创建时间 |
| updater | VARCHAR(64) | 否 | 更新者 |
| update_time | DATETIME | 否 | 更新时间 |
| deleted | BIT | 否 | 是否删除(0 否 1 是) |
| tenant_id | BIGINT | 否 | 租户 ID |
ai_knowledge_document 文档表
| 字段名 | 字段类型 | 是否必填 | 说明 |
|---|---|---|---|
| id | BIGINT | 是 | 主键 ID |
| knowledge_base_id | BIGINT | 是 | 所属知识库 ID |
| name | VARCHAR(200) | 是 | 文档名称 |
| type | VARCHAR(20) | 是 | 文档类型(pdf/docx/txt/md/html) |
| url | VARCHAR(1000) | 是 | 文件存储 URL |
| size | BIGINT | 否 | 文件大小(字节) |
| chunk_count | INT | 否 | 分段数量 |
| word_count | INT | 否 | 总字数 |
| total_tokens | INT | 否 | 总 Token 数 |
| status | TINYINT | 是 | 处理状态(0 待处理 1 解析中 2 分块中 3 向量化中 4 已完成 5 失败) |
| error_message | VARCHAR(500) | 否 | 失败原因 |
| process_progress | INT | 否 | 处理进度(0-100) |
| process_start_time | DATETIME | 否 | 处理开始时间 |
| process_end_time | DATETIME | 否 | 处理完成时间 |
| creator | VARCHAR(64) | 否 | 创建者 |
| create_time | DATETIME | 否 | 创建时间 |
| updater | VARCHAR(64) | 否 | 更新者 |
| update_time | DATETIME | 否 | 更新时间 |
| deleted | BIT | 否 | 是否删除(0 否 1 是) |
| tenant_id | BIGINT | 否 | 租户 ID |
ai_knowledge_segment 分段表
| 字段名 | 字段类型 | 是否必填 | 说明 |
|---|---|---|---|
| id | BIGINT | 是 | 主键 ID |
| document_id | BIGINT | 是 | 所属文档 ID |
| knowledge_base_id | BIGINT | 是 | 所属知识库 ID |
| content | TEXT | 是 | 分段文本内容 |
| word_count | INT | 否 | 字数 |
| tokens | INT | 否 | Token 数 |
| vector_id | VARCHAR(200) | 否 | 向量数据库中的 ID |
| position | INT | 否 | 在文档中的位置序号 |
| status | TINYINT | 是 | 状态(0 待向量化 1 已向量化 2 向量化失败) |
| creator | VARCHAR(64) | 否 | 创建者 |
| create_time | DATETIME | 否 | 创建时间 |
| updater | VARCHAR(64) | 否 | 更新者 |
| update_time | DATETIME | 否 | 更新时间 |
| deleted | BIT | 否 | 是否删除(0 否 1 是) |
| tenant_id | BIGINT | 否 | 租户 ID |
ai_knowledge_retrieval_log 检索日志表
| 字段名 | 字段类型 | 是否必填 | 说明 |
|---|---|---|---|
| id | BIGINT | 是 | 主键 ID |
| knowledge_base_id | BIGINT | 是 | 知识库 ID |
| user_id | BIGINT | 是 | 用户 ID |
| query | TEXT | 是 | 查询文本 |
| mode | VARCHAR(20) | 是 | 模式(chat/retrieval) |
| result_count | INT | 否 | 返回结果数量 |
| max_similarity | DECIMAL(5,4) | 否 | 最高相似度 |
| is_hit | TINYINT | 否 | 是否命中(最高相似度 ≥ 阈值) |
| token_cost | INT | 否 | 消耗 Token 数(问答模式) |
| response_time | INT | 否 | 响应耗时(毫秒) |
| feedback | TINYINT | 否 | 用户反馈(0 无 1 有帮助 2 没帮助) |
| creator | VARCHAR(64) | 否 | 创建者 |
| create_time | DATETIME | 否 | 创建时间 |
| tenant_id | BIGINT | 否 | 租户 ID |
ai_knowledge_vector_store 向量数据库配置表
| 字段名 | 字段类型 | 是否必填 | 说明 |
|---|---|---|---|
| id | BIGINT | 是 | 主键 ID |
| name | VARCHAR(100) | 是 | 连接名称 |
| type | VARCHAR(30) | 是 | 类型(redis/qdrant/milvus) |
| host | VARCHAR(200) | 是 | 连接地址 |
| port | INT | 是 | 端口号 |
| username | VARCHAR(100) | 否 | 用户名 |
| password | VARCHAR(500) | 否 | 密码(加密存储) |
| database_name | VARCHAR(100) | 否 | 数据库名/命名空间 |
| collection_name | VARCHAR(100) | 否 | 集合名称(Qdrant/Milvus) |
| vector_dimension | INT | 否 | 向量维度 |
| pool_config | JSON | 否 | 连接池配置(JSON) |
| extra_config | JSON | 否 | 额外配置(JSON) |
| status | TINYINT | 是 | 状态(0 禁用 1 启用) |
| creator | VARCHAR(64) | 否 | 创建者 |
| create_time | DATETIME | 否 | 创建时间 |
| updater | VARCHAR(64) | 否 | 更新者 |
| update_time | DATETIME | 否 | 更新时间 |
| deleted | BIT | 否 | 是否删除 |
| tenant_id | BIGINT | 否 | 租户 ID |
六、跨模块联动
6.1 联动关系总览
| 关联模块 | 联动方向 | 联动说明 |
|---|---|---|
| AI 对话(07-01) | 知识库 → AI 对话 | 问答模式复用对话模型生成答案 |
| AI 模型管理(07-01) | 知识库 → AI 模型管理 | 读取 Embedding 模型和对话模型配置 |
| 会员积分(05-02) | 知识库 → 会员积分 | 问答模式 Token 扣减 |
| 钱包管理(04-02) | 知识库 → 钱包管理 | Token 消费记录 |
| 统计分析 | 知识库 → 统计分析 | 检索数据汇入全局统计 |
6.2 详细联动设计
知识库 ↔ AI 对话(07-01)
| 联动场景 | 触发条件 | 联动行为 | 数据流向 |
|---|---|---|---|
| 问答生成答案 | 用户发起知识库问答 | 检索到的分段作为上下文,调用对话模型生成答案 | 知识库 → AI 对话 |
| 歌词/文本生成 | AI 对话中引用知识库 | 对话模块可指定知识库作为知识来源 | AI 对话 → 知识库 |
知识库 ↔ AI 模型管理(07-01)
| 联动场景 | 触发条件 | 联动行为 | 数据流向 |
|---|---|---|---|
| Embedding 模型调用 | 文档向量化或查询向量化 | 从模型管理获取 Embedding 模型配置 | AI 模型管理 → 知识库 |
| 对话模型调用 | 问答模式生成答案 | 从模型管理获取对话模型配置 | AI 模型管理 → 知识库 |
知识库 ↔ 会员积分(05-02)
| 联动场景 | 触发条件 | 联动行为 | 数据流向 |
|---|---|---|---|
| Token 扣减 | 问答模式消耗 Token | 扣减用户 Token 余额 | 知识库 → 会员积分 |
| 余额校验 | 用户发起问答 | 校验余额是否充足 | 知识库 ← 会员积分 |
知识库 ↔ 钱包管理(04-02)
| 联动场景 | 触发条件 | 联动行为 | 数据流向 |
|---|---|---|---|
| 消费记录 | Token 扣减完成 | 写入钱包消费流水 | 知识库 → 钱包管理 |
知识库 → 统计分析
| 联动场景 | 触发条件 | 联动行为 | 数据流向 |
|---|---|---|---|
| 检索数据汇总 | 定时任务(每 5 分钟) | 汇总检索次数、命中率、高频问题 | 知识库 → 统计分析 |
七、附录
7.1 名词解释
| 术语 | 说明 | 通俗理解 |
|---|---|---|
| 知识库(Knowledge Base) | 一个独立的知识容器,包含文档集合、向量数据和检索配置 | 一个"专题资料室",里面放着某个主题的所有资料 |
| 文档(Document) | 上传到知识库中的原始文件 | 你交给"图书管理员"的原始资料 |
| 分段/分块(Segment/Chunk) | 文档经过智能切分后的文本片段 | 管理员把厚书拆成一个个小卡片,每张卡片记一个知识点 |
| 向量化(Embedding) | 将文本转换为高维向量的过程 | 把文字翻译成"数字坐标",意思相近的文字坐标也相近 |
| 向量数据库(Vector Store) | 专门存储和检索向量的数据库系统 | 一个"坐标图书馆",能快速找到坐标最接近的卡片 |
| 语义检索(Semantic Search) | 基于语义相似度(而非关键词匹配)的搜索方式 | 不是找"包含某个词"的文档,而是找"意思最接近"的段落 |
| 相似度阈值(Similarity Threshold) | 检索结果的最低相似度要求 | "及格线"——相似度低于这条线的答案就不给你了 |
| Top-K | 检索返回的最相似结果数量 | "给你看前几名"——K=5 就是给你看最相关的 5 段 |
| 分块大小(Chunk Size) | 每个分段的最大字符数 | 每张"知识卡片"最多写多少字 |
| 分块重叠(Chunk Overlap) | 相邻分段之间重叠的字符数 | 相邻两张卡片有少量重复内容,防止一句话被从中间切断 |
| RAG(检索增强生成) | 先从知识库检索相关内容,再让 AI 基于内容生成回答 | 让 AI "开卷考试"而不是"闭卷考试",先查资料再回答 |
| Redis | 内存数据结构存储,通过 RediSearch 模块支持向量检索 | 用现有的 Redis 兼做向量搜索,适合小规模 |
| Qdrant | 开源向量数据库,专为向量相似度搜索设计 | 专业的"向量搜索引擎",中等规模首选 |
| Milvus | 开源向量数据库,支持大规模向量检索 | 企业级"向量搜索引擎",百万级以上数据用它 |
| 命中率 | 检索结果中最高相似度达到阈值的检索次数占比 | 100 次提问里有 80 次找到了相关资料,命中率就是 80% |
| Spring AI | Spring 生态的 AI 集成框架 | 连接各种 AI 服务的"万能转接头" |
| Token | 平台统一的 AI 资源计量单位 | AI 服务的"话费",用一次扣一点 |
| Apache PDFBox | 开源 PDF 文本提取库 | 从 PDF 文件里"抠出"文字内容的工具 |
| Apache POI | 开源 Office 文档处理库 | 从 Word 文件里提取文字内容的工具 |
7.2 权限标识
| 权限标识 | 说明 | 所属角色 |
|---|---|---|
| ai:knowledge:base:list | 查看知识库列表 | 运营人员、系统管理员 |
| ai:knowledge:base:create | 创建知识库 | 运营人员、系统管理员 |
| ai:knowledge:base:update | 修改知识库 | 运营人员、系统管理员 |
| ai:knowledge:base:delete | 删除知识库 | 系统管理员 |
| ai:knowledge:base:config | 配置知识库参数 | 运营人员、系统管理员 |
| ai:knowledge:document:list | 查看文档列表 | 运营人员 |
| ai:knowledge:document:upload | 上传文档 | 运营人员 |
| ai:knowledge:document:delete | 删除文档 | 运营人员 |
| ai:knowledge:document:reparse | 重新解析文档 | 运营人员 |
| ai:knowledge:segment:list | 查看分段列表 | 运营人员 |
| ai:knowledge:segment:update | 编辑分段 | 运营人员 |
| ai:knowledge:segment:delete | 删除分段 | 运营人员 |
| ai:knowledge:test:chat | 问答测试 | 运营人员 |
| ai:knowledge:test:retrieval | 检索测试 | 运营人员 |
| ai:knowledge:vector-store:list | 查看向量数据库配置 | 系统管理员 |
| ai:knowledge:vector-store:manage | 管理向量数据库配置 | 系统管理员 |
| ai:knowledge:statistics:view | 查看知识库统计 | 运营人员、系统管理员 |
| ai:knowledge:use | 使用知识库检索/问答 | 所有登录用户 |
| ai:knowledge:feedback | 提交问答反馈 | 所有登录用户 |